一步生成为什么常常需要多个大模型参与训练?分布匹配既需要生成器,又需要描述真实分布和当前生成分布的信号。TwinFlow 把这几个角色合入同一个网络:用正时间学习真实数据的流,用负时间学习自身生成数据的流,再用两者的速度差纠正一步生成。它主要解决的是大模型少步训练的复杂度和参数冗余。
论文 TwinFlow: Realizing One-step Generation on Large Models with Self-adversarial Flows,作者 Zhenglin Cheng、Peng Sun、Jianguo Li、Tao Lin,涉及 Inclusion AI、Shanghai Innovation Institute、Westlake University 和 Zhejiang University。ICLR 2026 官方会议录确认其发表来源。本文下载阅读的是 arXiv v2,更新于 2026 年 1 月 28 日,首版为 2025 年 12 月 3 日;数值按该版本表格整理。官方代码可供继续核查。本文没有执行训练或生成复现。
两条流共享参数,时间符号区分任务
标准线性 flow matching 把真实样本与噪声连接起来:
TwinFlow 先从噪声生成自己的样本,再把这张生成图与另一份噪声构造插值。真实样本分支输入正时间,生成样本分支输入负时间,参数由同一网络共享。原文 §3.1说明,构造生成样本插值的噪声不必与最初生成用的噪声相同。
负时间是模型的任务标识,用来区分需要学习哪个分布。它不要求推理时真的沿负时间做一次额外采样。生成样本分支通过 flow matching 学会当前生成分布,而真实样本分支保持对数据分布的建模。
这里的“无需固定教师”也有明确范围:不用额外维护固定教师来提供蒸馏目标,不代表实验中的 Qwen-Image、SANA 没有预训练初始化。
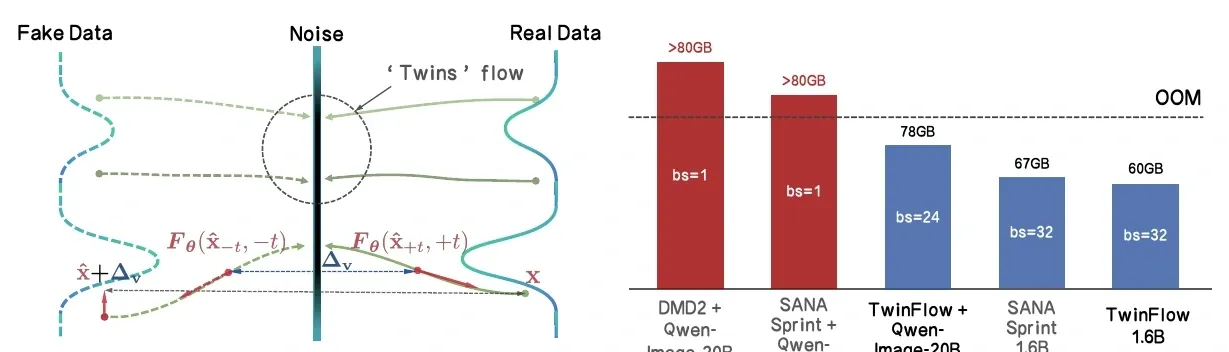
图源:论文 v2 图 2,第 3 页。左侧实线和虚线对应共享网络中的两类流,速度差构成纠偏信号。右侧柱图涉及 Qwen-Image-20B 的 LoRA 训练和 SANA-1.6B,batch size 不同;显存结论应连同分辨率、模型和批大小一起读,不能当作任意配置的显存需求。
图 2 左半部分需要区分轨迹示意与实际训练步骤:
- 右侧实线连接噪声与真实数据,正时间条件让网络学习真实分布的速度场。
- 左侧虚线连接噪声与当前模型生成的数据,负时间条件让同一网络学习生成分布的速度场。两条曲线对应两种任务,并不是两套独立参数。
- 中间局部放大区域表达速度差:在同一个加噪样本位置,分别以正、负时间条件求值,得到两个向量,再相减形成 。不能把图中左右不同位置的箭头直接相减,当作实现算法。
训练时先生成样本,再对它重新加噪,随后查询两种速度;生成流的 flow matching 目标学习“当前模型产生了什么”,rectification 目标再利用差值推动生成路径靠近真实分布。推理时走学好的生成路径,不需要把图中所有分支再执行一遍。依据:论文 §3.1–3.3、图 2。
速度差为什么可以纠偏
如果只学习两条流,模型仍然可能很准确地描述一个质量较差的生成分布。真正驱动一步生成改进的是 rectification loss。
论文从生成分布与真实分布的 KL 散度梯度出发,在采用线性插值的条件下,将 score 差改写为速度差。对相同的加噪生成样本,分别以正负时间查询网络:
这个差值提供纠偏方向,随后通过 stop-gradient 目标把信号传给生成路径。原文 §3.2、公式 3–9 与附录 C.1给出推导。
直观上,真实流描述数据应该往哪里走,生成流描述当前模型实际上生成了什么,两者之差指出需要修正的部分。这一解释建立在速度场对相应分布有足够准确估计的前提下;实际神经网络的误差、共享参数之间的干扰,并不会因理论改写自动消失。
因此它虽然称为 self-adversarial,也不需要传统真假分类 GAN 判别器。对抗性来自真实与生成分布之间的差异。
保留多步能力,需要基础目标共同约束
TwinFlow 并非只训练一个直接输出端点的损失。原文 §3.3把它接入 any-step 框架:
基础目标维持不同时间区间上的生成能力,生成流目标学习自己的样本分布,纠偏目标提升少步效率。实现时把 mini-batch 分成两部分:基础目标使用随机目标时间,TwinFlow 部分固定目标时间为零,比例由超参数控制。
这也说明“共享一个模型”的收益主要在参数和角色管理上。训练仍然包含多次网络调用、额外目标和梯度组织,不能推断训练 FLOPs 与普通 flow matching 完全相同。
Qwen-Image:LoRA 与全参数结果分开读
以下来自 v2 表 2、表 3。GenEval 沿用 0–1 尺度;DPG-Bench 沿用原表尺度,越高越好。这里选择没有额外提示改写标记的数值。
| 设置 | NFE | GenEval | DPG-Bench |
|---|---|---|---|
| 原始 Qwen-Image | 100(50×2) | 0.87 | 88.32 |
| TwinFlow,LoRA | 1 | 0.86 | 86.52 |
| TwinFlow,LoRA | 2 | 0.87 | 87.64 |
| TwinFlow,全参数 | 1 | 0.85 | 85.44 |
| TwinFlow,全参数,延长训练 | 1 | 0.89 | 87.54 |
| TwinFlow,全参数,延长训练 | 2 | 0.90 | 87.80 |
这里可以看到一步质量接近原始模型,延长训练仍有收益。但这些是不同训练设置,不能拿延长训练的分数解释成共享参数本身带来的全部提升。表 3 的部分对照还使用 fake-score LoRA 或有限差分 JVP 等可运行设置,结论应与这些条件一起阅读。
原模型的 50×2 包含 classifier-free guidance 对条件和无条件分支的求值。降到 1 NFE 表示该口径下网络调用减少百倍,不等于整条服务链路快百倍;文本编码、VAE、调度和硬件利用率还在。
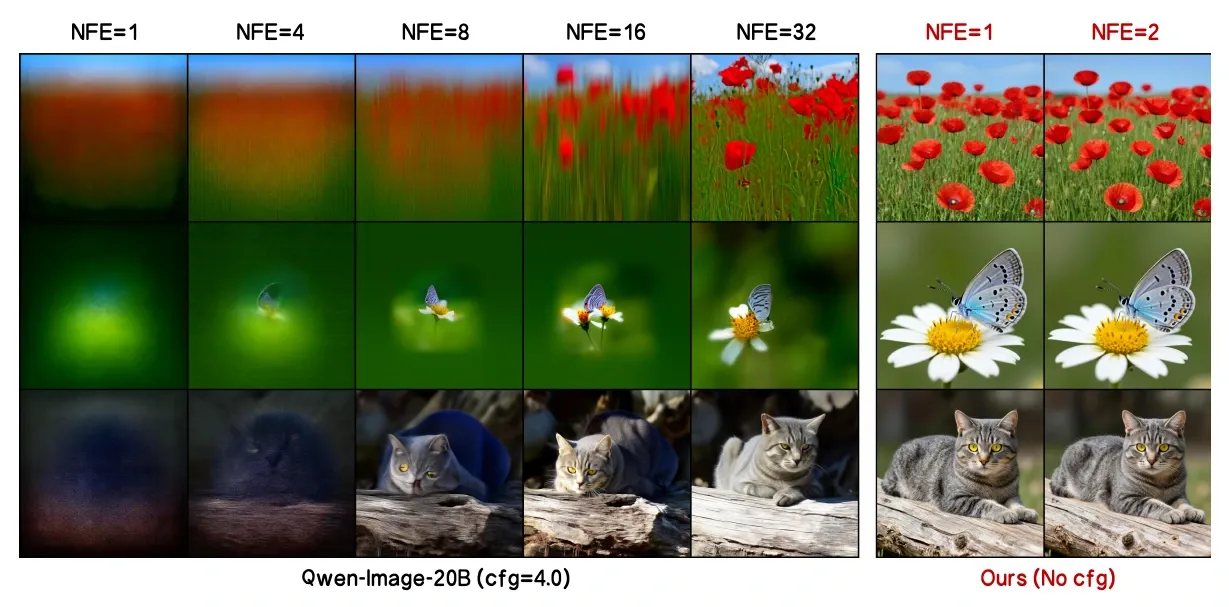
图源:论文 v2 图 3,第 9 页。左侧是使用 CFG 的原始模型,右侧是不用 CFG 的 TwinFlow,展示少步时结构建立的差别。图中 NFE 与 CFG 标注应同时阅读;这些定性样例不能替代统一评测或端到端延迟实测。
SANA:主要收益落在一步质量
v2 表 4在单张 A100、BF16 下测量吞吐与延迟,吞吐 batch 为 10,延迟 batch 为 1。SANA 0.6B 对照如下:
| 方法 | NFE | GenEval | DPG-Bench | 单图延迟 |
|---|---|---|---|---|
| RCGM-0.6B | 1 | 0.80 | 77.2 | 0.23 秒 |
| TwinFlow-0.6B | 1 | 0.83 | 78.9 | 0.23 秒 |
| RCGM-0.6B | 2 | 0.85 | 80.3 | 0.26 秒 |
| TwinFlow-0.6B | 2 | 0.84 | 79.7 | 0.26 秒 |
相同 NFE 下,收益主要是质量,不是额外推理提速;到了两步,RCGM 在这两个指标上反而略高。论文支持 TwinFlow 对极低步数尤其有帮助,不能外推为所有步数都占优。
多样性证据与适用范围
v2 附录 D.1、表 9在 GenEval 中为每个提示生成四张图,计算成对 LPIPS 距离:一步 Qwen-Image-Lightning 为 0.2996,TwinFlow 为 0.5044。这个结果支持该设置下 TwinFlow 的样本差异更大,但 LPIPS 不直接衡量正确性,也不能覆盖所有后来发布的 Lightning 权重和配置。
图像编辑实验则只是约 1.5 万编辑对上的四次求值探索,不能把文生图的一步结论直接移植过去。原文 §4.2也将其定位为初步实验。
我的判断是,TwinFlow 最有价值的工程方向是减少大模型训练时重复维护的角色,使 20B 规模的少步全参数训练更可行。共享参数的代价、真实与生成分支的误差耦合,以及业务场景中的文字、布局、多样性,仍需要分别验证。
与 NitroFusion2 一起看
NitroFusion2 解读关注监督表示:让多模态文本状态承担判别职责,再用方面 cue 分配监督重点。TwinFlow 关注监督来源:将真实分布和生成分布的速度估计装入同一网络,通过差值构造纠偏。
两条路线的比较应放在相同骨干、数据和评测设置下。TwinFlow 原文的 Qwen-Image/SANA 分数,与后来 NitroFusion2 的 Z-Image 对照表,不能直接拼成统一排行榜。对实际部署,更有用的问题是:在确定的质量门槛下,一步是否足够,增加到两步能挽回哪些失败模式,以及为训练这份加速需要承担多少资源成本。