把文生图压缩到一步,困难在于模型必须一次完成布局、纹理和文字。NitroFusion2 的关键选择是:让判别器读取已经与图像交互过的文本 token 状态,再用不同的文字条件引导它检查不同属性。论文的一步结果明显改善,但文字生成仍未追平八步参考,多样性也有代价。
本文阅读的是 Dar-Yen Chen、Yi-Zhe Song 的 NitroFusion2: Bringing Adversarial Loss to the Text Stream of Multimodal Diffusion Transformers,机构包括 University of Surrey 的 SketchX/CVSSP 和 Turing Elite Research Labs。版本为 arXiv:2611.05648v1,2026 年 11 月 3 日提交;目前核实到的是预印本。官方代码与模型页提供发布资源。本文是论文分析,没有执行模型训练或推理复现。
文本流为什么能判断图像
传统 cross-attention UNet 读取独立计算的文本编码,图像不会改写这些文本表示。直接在这种表示上挂判别头,无法通过文本特征把图像质量的梯度传回生成器。
MMDiT 的 joint attention 改变了这个条件。文本和图像 token 共同参与注意力计算;文本查询得到的输出可以拆成:
其中第一项来自图像 token。因此,同一句提示面对不同图像时,中间文本状态也会不同。论文的 Text-Stream Adversarial Distillation(TSAD)就在选定层的文本注意力输出上挂轻量判别头,同时保留图像流判别头。原文 §3.2给出了这一依赖关系。
这里容易混淆的是:被读取的不是原始文本编码器输出,而是扩散骨干中已经融合图像信息的文本状态。冻结判别骨干意味着不更新它的权重,生成器更新时仍需要梯度穿过这条计算路径。
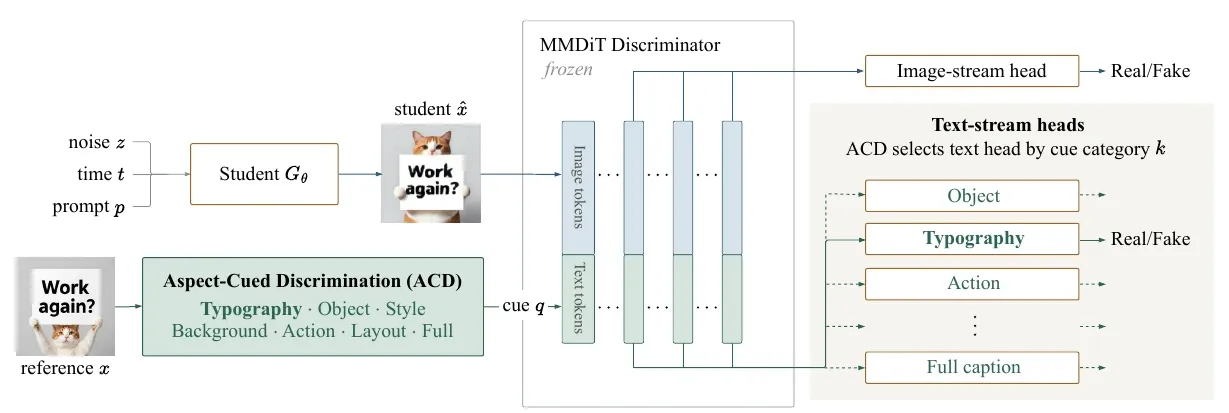
图源:论文 v1 图 2,第 4 页。图中的两条监督分支共享冻结骨干;ACD 同时控制判别条件与文本头的选择,学生仍读取原始提示。
读这张原理图可以沿三条路径展开:
- 生成路径:左上角的噪声、时间和原始 prompt 输入学生,输出生成 latent。参考图像与生成图像都在相应噪声水平下送入判别骨干;图中省略了部分加噪细节。
- 条件路径:左下角从参考图像得到结构化字段,抽取 cue 后送给判别骨干。学生的 prompt 与判别器的 cue 承担不同职责,前者定义生成任务,后者定义本次检查重点。
- 监督路径:骨干同时输出图像与文本注意力特征。图像头跨 cue 共享,文本头按 cue 分组;更新判别头时学习区分参考与生成,更新学生时让生成样本得到更高分。
图中把文本流放在判别链路上,依赖的正是上式中的 :文本状态必须含有当前图像的信息,才能把监督传回学生。冻结骨干不等于切断这条梯度路径。方法增加的是训练阶段的监督设计,推理时只保留学生,不运行整套判别器。依据:论文 §3.1–3.5、图 2。
ACD:每次让判别器检查一个方面
Aspect-Cued Discrimination(ACD)把参考图像的描述拆成 typography、object、style、background、action、layout 六个方面,加上完整描述。每次训练从有效字段和完整描述中均匀抽一个 cue;不存在的属性留空,不参与抽样。
生成器继续使用原始 prompt,判别器改用抽到的 cue。同一对参考图像和生成图像使用相同 cue,文本流还会路由到对应方面的判别头。图像流判别头则跨 cue 共享。原文 §3.3–3.4说明,这个数据集有 10 万张 Z-Image-Turbo 十二步合成参考图,英文、中文提示各半,再由 Qwen3.5-35B-A3B 看图生成结构化描述。
可以把这理解为改变判别器的问题:检查字是否写对,和检查主体是否出现,使用同一个骨干,但读取重点不同。这是对设计的直观解释;注意力图只能展示 cue 与关注位置的关系,不能单独证明质量提升完全由注意力迁移造成。
论文所说的额外开销很小,具体指文本头和图像头共享判别骨干的一次前向,且每次只抽一个 cue;不能据此把整个对抗训练视作没有额外计算。
损失如何组合
参考和生成 latent 都先加噪到相同噪声水平。训练交替更新轻量判别头与学生,骨干保持冻结。判别头采用 hinge loss;学生提高自身样本的判别 logit,并在低噪声区域加入参考回归:
原文 §3.5使用图像流权重 0.1、回归权重 0.1,回归范围为噪声时间不超过 0.75。这样既强调文本组织的属性,又保留局部图像监督和参考约束。
一步提升明显,两步结果需要逐项看
以下来自论文表 1,均为 Z-Image 系列的 6B 模型,数值沿用原表尺度,越高越好。NFE 是网络求值次数。
| 模型 | NFE | LongText-EN | LongText-CN | GenEval | DPG-Bench | OneIG |
|---|---|---|---|---|---|---|
| Z-Image-Turbo | 1 | 11.72 | 12.70 | 57.08 | 77.23 | 32.43 |
| TwinFlow | 1 | 29.18 | 36.85 | 66.34 | 85.17 | 42.20 |
| NitroFusion2 | 1 | 43.34 | 47.78 | 75.86 | 86.48 | 47.63 |
| NitroFusion2 | 2 | 76.03 | 81.95 | 74.46 | 86.21 | 51.45 |
| Z-Image-Turbo | 8 | 91.74 | 92.56 | 75.01 | 84.86 | 52.84 |
一步 NitroFusion2 在这组对照的五项指标上都领先一步基线,文字收益尤其清楚。但八步参考的文字指标仍明显更高;两步 NitroFusion2 的 GenEval 还略低于自身一步结果。不同指标不会随步数统一增长。
这些数值支持的是特定评测下的质量与步数折中。不能把八分之一 NFE 直接写成端到端延迟降为八分之一,编码、解码和运行时开销仍需设备实测。
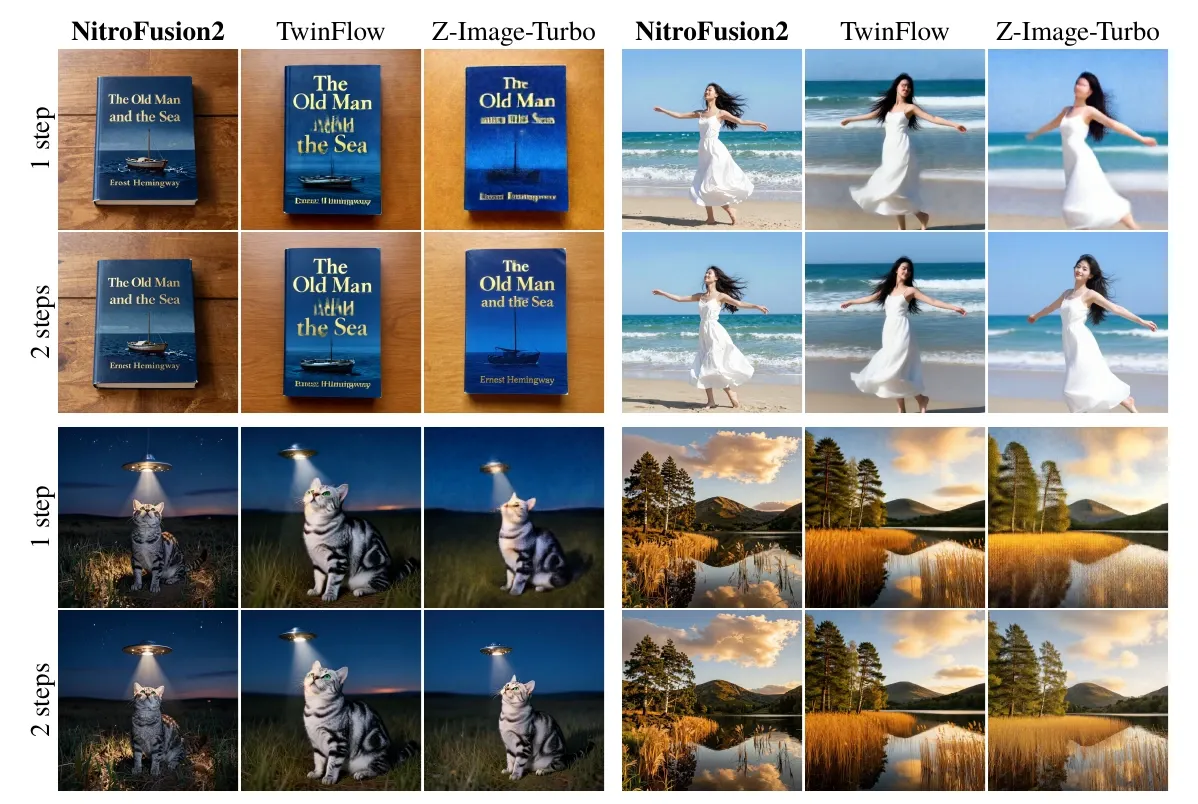
图源:论文 v1 图 4,第 6 页。每组按列比较模型、按行比较一步与两步。书封展示文字清晰度,人物、猫和风景展示结构与细节;这是作者选择的定性样例,整体优势仍应结合上表判断,不能据此推断所有提示都可靠。
消融支持了什么,还没隔离什么
表 3在训练 1000 步、一步评测的设置中比较流的选择:文本流单独使用时五项指标均高于图像流,联合使用又改善其中四项,GenEval 例外。这支持文本状态确实能提供有用监督。
不过,文本头按 cue 分组,图像头共享,容量与专门化程度也随设置变化。我的判断是:这组结果支持当前文本流方案有效,但尚不足以把全部优势归因于文本表示本身。若要隔离表示因素,需要让图像流同样使用方面专属头,并匹配参数量与训练预算。
表 4更直接检验 cue:固定联合判别架构,换用不同条件。typography 专项训练得到 45.06/53.01 的英中文字指标,高于混合 cues 的 24.47/26.63;混合方案在风格、实体和对齐等项目上更均衡。这里比较的是短程消融,不能与最终模型的训练预算混用。
结果说明 cue 是训练资源分配手段,也暴露了跷跷板效应:强化一种属性可能牺牲其他属性。
对一步生成的启发
论文 §5 明确承认复杂场景、多样性下降、cue 之间相互牵制和选层尚未最优等限制;参考数据也来自合成分布。把 GenEval 或 DPG-Bench 的高分理解成所有维度都保真,会漏掉这些边界。
这项工作值得借鉴的设计是:多模态模型中的条件 token 在交互后,可能成为可按问题组织的视觉监督表示。工程上若要采用,首先应针对目标业务比较一步和两步的文字准确率、复杂布局以及同一提示下的多样性,再决定是否接受这份速度与质量的交换。
同样关注一步生成的 TwinFlow 选择了另一条路径:用共享模型中的真实与生成速度场构造纠偏信号。