标准 Vision Transformer 有时会把背景 patch 变成异常高范数 token。论文作者观察到,这些 token 常出现在天空、墙面等低信息区域,并提出一种解释:模型借用它们保存中间计算状态。论文接下来要回答三个问题:这些 token 在做什么、训练时加入 register 能否提供专用工作空间,以及收益是否主要体现在空间任务。
把它们比作“垃圾桶”容易理解,但可能让人以为这些 token 只是无用噪声。按论文作者的解释,背景 patch 像是被临时当成工作寄存器:它们可能保存模型计算需要的中间状态,因此不再忠实表示对应的图像区域。
flowchart LR
  A[低信息背景 patch] -. 论文假说 .-> B[被复用作内部计算位置]
  B -.-> C[高范数 / 全局信息聚集]
  C -.-> D[局部特征与注意力图尖峰]
  R[训练时加入 register] --> E[部分注意力转向 register]
  E --> F[高范数热点减少]
  F --> G[空间特征更平滑]
论文信息
| 字段 | 内容 |
|---|---|
| 标题 | Vision Transformers Need Registers |
| 作者 | Timothée Darcet、Maxime Oquab、Julien Mairal、Piotr Bojanowski |
| 会议 | ICLR 2024 |
| 研究对象 | supervised 和 self-supervised ViT |
| 代码 | facebookresearch/dinov2 |
| 论文 | arXiv:2309.16588 |
一句话总结:论文发现,训练时加入不对应图像位置的 register 后,高范数 patch 和空间特征热点减少;作者将这一变化解释为模型获得了专用的中间计算位置。
先看现象:背景里的高范数 token
标准 ViT 把图片切成 patch,再把每个 patch 映射成 token:
image
  -> image patches
  -> patch tokens
  -> Transformer blocks
  -> visual representation
理想情况下,一个 patch token 应该主要描述对应的图像区域。但作者观察到,很多预训练 ViT 会产生一些异常 token:
token norm 很高
位置却在背景区域
语义上没有明显物体
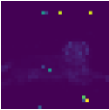
把 token 的范数画回图像空间后,就会看到几个稳定的热点。这些热点不是输入图像本身的显著目标;仅凭这个现象也无法判断它们是不是噪声或承担了什么功能。
这给下游视觉任务带来一个风险。分类主要依赖全局表示,可能不容易受影响;分割、深度估计和目标发现则依赖 patch 与图像位置的对应关系,异常 token 可能干扰这些任务。但热点图本身还不能证明任务性能因此下降,后文需要看下游评测。
论文统计了正常 patch 和 artifact patch 的范数分布。异常位置的长尾非常明显,这也是“背景里冒出几个尖峰”的定量证据。
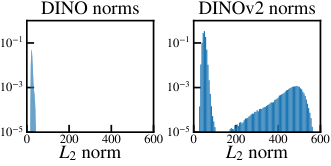
以 DINOv2 ViT-g 为例,作者将输出范数大于 150 的 patch 定义为 outlier;约 2.37% 的 patch 落在这一区间。150 只是该模型双峰分布下便于区分的阈值,不是可迁移到其他 backbone 的默认超参数;实际诊断应看范数分布与空间位置。
下面是未加入 register 时的一组空间特征响应图。少数背景位置出现强激活,响应也不总与物体轮廓一致。这能显示异常出现在哪里,但还不能说明这些 token 承担了什么功能。
为什么模型会借用背景 patch
Transformer 的 self-attention 允许任意 token 互相读写。某个 token 不一定只保存“它所在 patch 的信息”,也可以成为全局信息交换的中转站。
基于这个性质,论文作者提出一个机制假说:序列里没有专门的工作位置时,模型可能复用低信息背景 patch 来保存中间计算状态。
正常背景 patch
  -> 被模型选中
  -> 范数被放大
  -> 承担中间计算
  -> 不再纯粹表示原始背景
这里的因果解释是作者对异常 token 的机制假说,不是从热力图直接得出的结论。它预测:如果背景 patch 被用于全局计算,这些 token 应该更少保留局部内容、同时含有更多全局信息。
register 的动机与 CPU 寄存器相似:它不代表外部输入中的某个实体,而是给计算过程提供临时存储。
不过这个类比需要加一个限定:ViT 中的高范数 patch 并不是硬件寄存器,也不是一个预先定义好的离散缓存。它是模型在训练后自己形成的行为。论文做的是提供更合适的 token,让这种行为有专门的落脚点。
检验机制假说:这些 token 保留了什么信息
论文从 token 出现的训练阶段、模型规模以及 token 保留的信息等方面做了几组分析:
| 观察 | 结果 | 含义 |
|---|---|---|
| 出现位置 | DINOv2 ViT-g 的范数分叉约从 40 层网络的第 15 层开始 | 不是 patch embedding 的输入噪声,而是中层形成的策略 |
| 训练与规模 | 大约训练三分之一后才明显;DINOv2 在 ViT-L 及以上模型出现 | 需要容量和优化过程,像一种学到的计算分工 |
| 局部信息 probe | 正常 / outlier 的位置 top-1:41.7% / 22.8%;像素重建 L2:18.38 / 25.23 | outlier 不再忠实表达自身位置和像素 |
| 全局信息 probe | ImageNet-1k 线性分类:普通 token 65.8%,outlier 69.0% | outlier 聚集了额外的整图语义 |
局部与全局 probe 支持了假说的关键部分:这些 token 对自身位置的局部信息较弱,却含有更多整图语义。训练时序和规模上的现象与“逐渐学出的计算分工”相符,但这类相关观察本身不能证明“缺少工作位置导致了异常 token”。因此论文进一步在训练时加入 register,观察提供替代工作位置后 token 行为是否改变;这个对照可以检验 register 是否产生影响,但不能单独证明它是唯一机制。
方法:增加 register tokens
普通 ViT 的输入序列大致是:
[CLS] + patch_1 + patch_2 + ... + patch_N加入 registers 后变成:
[CLS] + register_1 + ... + register_R + patch_1 + ... + patch_Nregister token 是额外的可学习 token。它们没有对应的图像区域,也不参与最终的空间特征图。Transformer 可以通过 attention 读取和更新它们,把它们作为中间计算的工作区。
形式上,标准输入 (X0=[x{cls};x1,\ldots,x_P]+E{pos}) 变为 (X0=[x{cls};r1,\ldots,r_R;x_1,\ldots,x_P]+E{pos})。(r_i) 与 CLS 一样可学习、每层都参与 self-attention;最终仅将它们从输出序列剔除。它们不为 patch 补位置编码,也不改变 patch 的二维对应关系。
关键点是:register 不负责识别某个物体,也不是新的类别 token。它只是把模型原本隐式使用的工作空间显式提供出来。
下图是论文对输入序列的示意:register tokens 插在特殊 token 和图像 patch tokens 之间,训练时和 Transformer 一起参与计算,输出空间特征时则可以把它们排除。
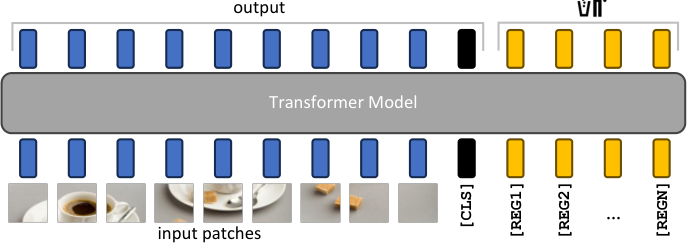
推理时,做 dense prediction 通常只取 patch tokens,去掉 [CLS] 和 register tokens,再把 patch token 还原到二维网格。这样输出只包含有图像位置对应关系的 patch token;作者认为,这有助于避免把内部计算状态混入空间特征。
它不是简单地多加几个 [CLS]
[CLS] token 和 register token 的用途不同。
[CLS] 通常承担全局聚合任务,最后用于分类或图像级表示;register tokens 则是 Transformer 内部可以反复读写的工作空间。它们不需要对应一个最终输出,也不需要代表整张图的语义。
可以粗略地这样区分:
[CLS]    -> 汇总整张图,服务于全局任务
register -> 保存中间计算,服务于模型内部
patch    -> 表示图像空间中的局部内容
这也是为什么 register token 最终可以从 dense feature map 中排除:它们从一开始就不是空间采样点。
干预结果:从 token 行为到下游任务
作者在监督和自监督 ViT 上训练带 register 的模型,再观察 token 行为、空间特征和下游指标是否变化。这个对照直接检验“加入 register 会不会改变模型表现”,也为前面的工作空间假说提供干预证据。
下面按证据层次展开:先看加入 register 后直接观察到的注意力、范数和特征图变化,再看独立评测的下游任务指标。前几项变化和指标改善同时出现,但论文没有证明前者是后者的唯一中介原因。
1. 注意力转向 register
加入 register 后,部分 attention head 中原本落在背景 patch 上的注意力转向 register。这与“模型需要中间工作位置”的假说相符,是干预后观察到的机制变化。
2. 高范数背景 token 减少
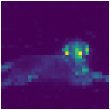
加入 register 后,原来集中在背景位置的高范数 token 大幅减少。按工作空间假说,一种解释是模型不再需要复用天空、墙面或地面上的 patch。与前面的基线图对照,加入 1 个 register 后,主要可见热点已减弱;不同数量的 register 结果如下。
3. 空间特征图更平滑
patch feature 的空间分布更加连续,局部区域之间的变化更符合图像内容,而不是被几个异常热点打断。这个变化与异常 token 减少同时出现,支持空间表示被改善的解释。
4. Dense prediction 更好
作者还在语义分割、深度估计和目标发现等任务上评测带 register 的模型。尤其在目标发现中,当模型规模变大时,加入 register 的模型让 object discovery 方法继续工作得更稳定。
这篇论文的重点不是宣称 registers 会让所有分类准确率都大幅上升,而是报告:带 register 的预训练视觉特征在若干空间密集型下游评测中取得了更好的结果。
论文在多个 dense prediction 设置中比较了加入 registers 前后的结果。分割和深度估计指标的变化是独立的任务评测结果;它们与特征图变平滑同时出现,但不能据此断定后者直接导致了前者。
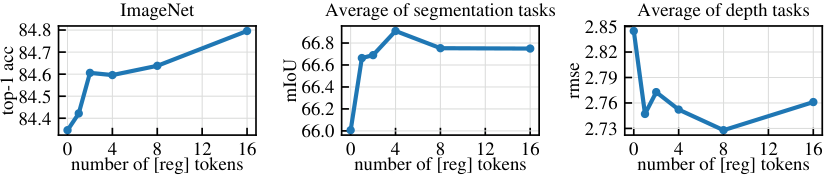
原文中最有代表性的冻结特征评测如下:
| 评测 | 原模型 | + register |
|---|---|---|
| DeiT-III / ImageNet Top-1 | 84.7 | 84.7 |
| DeiT-III / ADE20K mIoU | 38.9 | 39.1 |
| OpenCLIP / NYUd RMSE(低更好) | 0.702 | 0.661 |
| DINOv2 / ImageNet Top-1 | 84.3 | 84.8 |
| DINOv2 / ADE20K mIoU | 46.6 | 47.9 |
| DINOv2 / NYUd RMSE(低更好) | 0.378 | 0.366 |
重点不是分类涨点,而是加入 register 没有牺牲分类表示能力;对空间特征更敏感的 ADE20K、NYUd 给出更清晰的收益。在无监督目标发现 LOST 上,DINOv2 + register 的 CorLoc 从 35.3 -> 55.4(VOC 2007)、40.2 -> 60.0(VOC 2012)、26.9 -> 42.0(COCO-20k)。OpenCLIP 在这一特定启发式上略降,说明收益不适用于所有下游算法。
这些对照支持“训练时加入 register 能改善所测任务”的结论。把收益进一步归因于“特征图变干净”是合理的机制解释,但论文没有单独量化特征清理对每项任务指标的中介贡献;因此不应把这一步写成已被独立证明的因果关系。
数量、代价与正确用法
作者在 DINOv2 ViT-L/14 上测试 0、1、2、4、8、16 个 register。1 个已能去掉主要伪影;更多 register 对部分 dense task 有额外帮助,论文多数实验选择 4 个。代价来自 attention 序列变长:4 个时额外 FLOPs 低于约 2%,16 个时可到约 6%。
- 不能对已经训练好的普通 ViT 在推理时随意拼随机 token。本文的 register 是训练中共同优化出来的;无法重训的 checkpoint 应看 RegCache。
- 下游恢复 (H\times W) 特征网格时,必须显式去掉
CLS和所有 register,不能把它们 reshape 成图像 patch。
“垃圾桶”这个比喻到底对不对
可以把背景 token 看成垃圾桶,但最好分成两层意思:
直观说法:模型把不重要的背景 patch 当成垃圾桶
准确说法:模型把背景 patch 当成临时工作寄存器
“垃圾桶”强调的是这些 token 不再忠实表示所在位置;“寄存器”强调的是它们实际上承担了有用的计算功能。后者更接近论文结论。
如果模型真的只是把无用噪声塞进背景 token,清理它们可能只需要正则化。论文选择增加 register tokens,体现了作者的机制解释:模型有计算需求,却缺少合适的专用位置。probe 和 register 干预结果与这一解释相符,但仍不能排除其他机制。
对模型使用者有什么意义
如果只做图像分类,异常 token 可能不容易暴露,因为分类主要依赖全局表示。但如果使用 DINO、DINOv2 或其他 ViT foundation model 做以下任务,就应该关注这个问题:
- 语义分割和实例分割;
- 深度估计;
- 特征匹配和图像检索;
- 目标发现和无监督目标定位;
- 任何需要把 token 还原为空间特征图的任务。
实际使用时,优先选择已经训练了 registers 的模型版本。不能简单地给一个已经训练好的普通 ViT 在推理阶段拼上几个随机 token,因为 register 的行为需要在训练过程中形成,新增 token 的参数和模型内部协作方式都需要被学习。
这也是后来很多视觉模型名称里出现 Register 或 DINOv2 with registers 的原因:它不是为了增加一个新的视觉模块,而是把 Transformer 原本隐式形成的工作空间显式化。
局限和边界
这篇论文并没有证明所有 ViT 都必须使用 registers,也没有说任何异常高范数 token 都是坏的。
首先,某些高范数 token 可能确实承载了有用的全局信息。是否应该移除它们,要看下游任务如何使用 feature。其次,register 数量和插入位置仍然是架构与训练配置的一部分,不是一个完全免费的推理补丁。最后,register 针对的是 token 空间可能被内部计算占用的问题,它不能替代更好的数据、预训练目标或下游任务设计。
与 RegCache 的衔接
本文讨论训练时的结构性预防:让模型从训练开始就使用专用 register。下一篇 RegCache 处理已训练 checkpoint 的部署问题:用中层 KV prefix 模拟可复用 register,并删除残留 sink token,以缩小 activation quantization range。两者关注同一机制,但适用时机不同。
最后总结
这篇论文最值得记住的不是“加了几个 token”,而是它提出并检验的解释:
ViT 会产生高范数背景 token。
论文假说:部分 token 被复用来保存全局计算状态。
训练时加入 register 后,异常热点减少,空间特征更平滑。
在所测 dense prediction 任务中,部分指标随之改善。
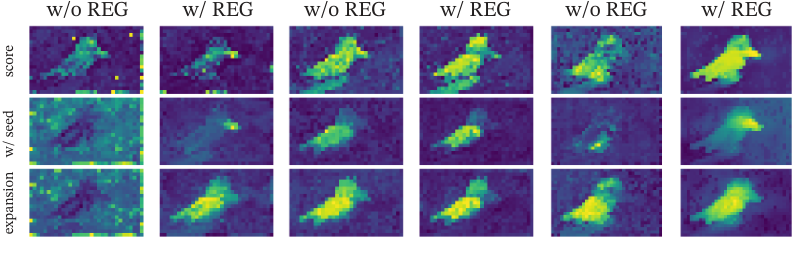
可视化上,加入 registers 后,patch feature 的空间响应更规律,原本集中在少数位置的异常响应被削弱;注意力变化也显示部分计算转向 register。这些是干预后的观察,支持但不能独立证明完整的工作空间解释。
在另一个图像例子中,响应集中到物体主体区域的程度更高,而不是零散地落在背景上。这展示了 register 模型空间特征的一个直观差异;单个可视化例子不能代表所有图像或任务。
因此,论文的实验显示:训练时增加 register 与异常热点减少、空间特征变化及若干下游指标改善相关。作者将这组结果解释为 register 为模型提供了临时工作空间;这条机制解释与证据相符,但下游收益究竟有多少由特征清理中介,尚未被单独量化。