把 ViT 导到 INT8 后遇到精度下降,应该先调 PTQ 算法,还是先查激活在哪一层、哪类 token 上失去可量化性?本文记录我们对 DINOv3 ViT-B/16 做的 64 张图像 FP32 逐层 profile:少数 learned register token 在 block 2 把某个 activation tensor 的范围拉到 patch token 的数百倍,单一 A8 scale 难以同时覆盖两者。
这是一项量化前的分布诊断,不等于已经验证了端侧 W8A8 修复方案。下文会说明测量方法、LayerScale 在异常放大链中的位置,以及对 Qualcomm V68 部署提出的下一步假设。
先给结论
| 配置 | 64 图平均输出余弦 | 含义 |
|---|---|---|
| W8 权重,FP 激活 | 0.99950 | 权重量化基本无损 |
| W8A16 | 0.97724 | 提高 activation 精度后可用 |
| 标准全图 W8A8 | -0.00333 | 单尺度 activation quantization 失效 |
因此,首先排除“权重 per-channel 不够好”的方向。问题在 activation,而且不是均匀地出现在所有层。
本文的余弦是 ONNX 输出 feature 的相似度,不是分类 Top-1。量化使用 AIMET-ONNX MinMax 仿真:W8 per-channel weight、static per-tensor activation,64 张校准图和独立 64 张评测图;输入严格复用部署脚本的 BGR-to-RGB、resize 128、
(x / 255 - 0.5) / 0.5前处理。
我们量的是什么
这里不是权重直方图,也不是单张图的 input distribution,而是 FP32 图中关键边界的输出激活。对 12 个 Transformer block 的 norm1/qkv/softmax/attention projection/ls1/add1/norm2/fc1/gelu/fc2/ls2/add2 加 final norm,共 145 个边界,分别统计:
- CLS(1 个 token);
- learned registers(4 个 token);
- image patches(64 个 token)。
除 min/max、均值、标准差和元素分位数外,最重要的指标是每个 token 的 L-infinity norm,即该 token 的最大绝对通道值。它直接回答了“哪个 token 决定 activation scale”。文中的统计基于 64 张图像的逐层 FP32 profile,原始统计同时保留为 JSON 和 Markdown 表格。
图一:异常从 block 2 开始,并留在残差主干
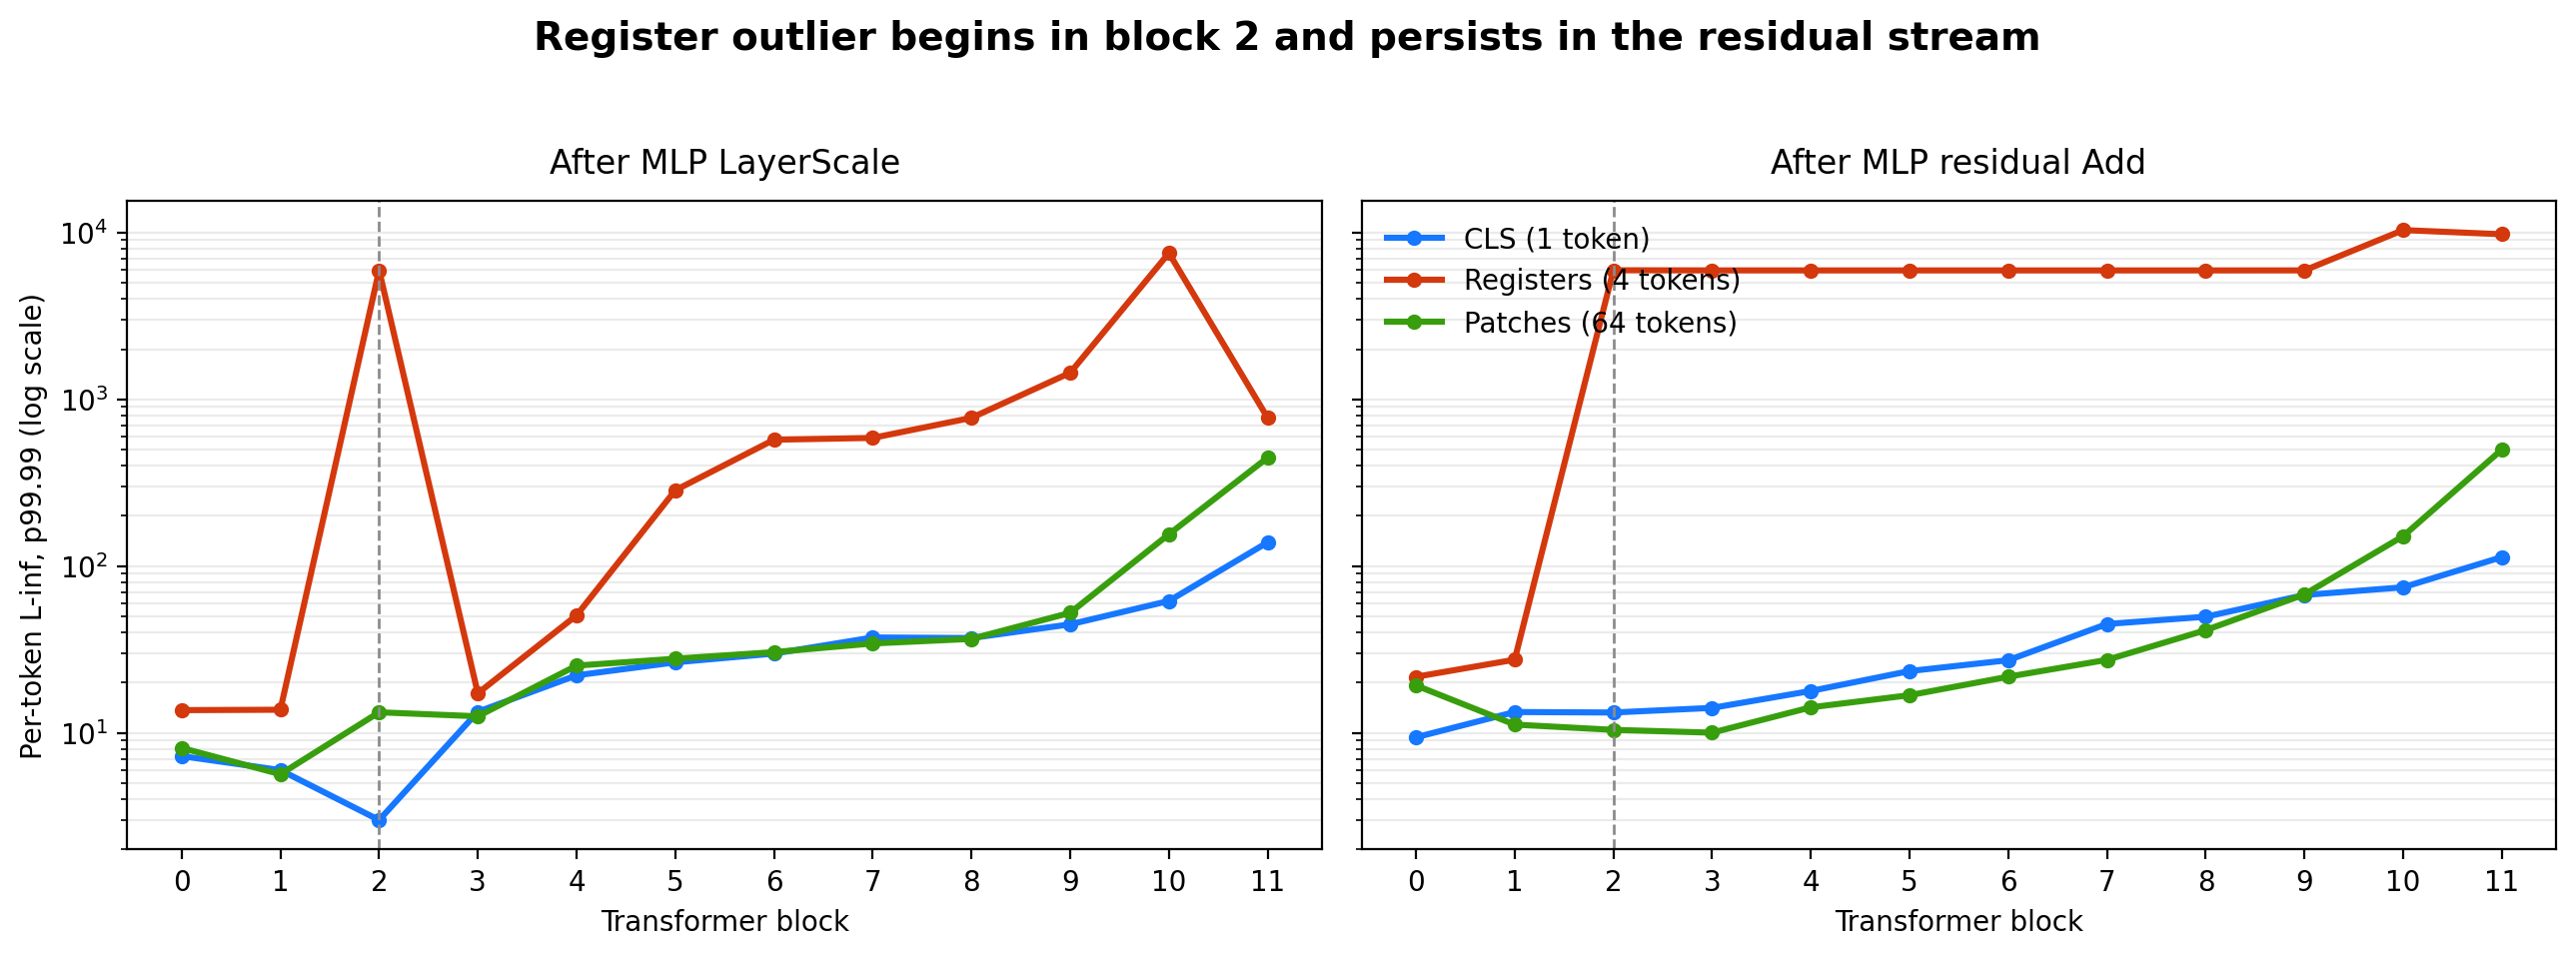
图中虚线是 block 2。此前 register、CLS、patch 的量级大体接近;block 2 的 MLP LayerScale 后,register 突然到 5942.8,而 patch 只有 13.30。随后看右图的 residual Add:register 的巨大状态没有消失,而是进入并长期留在 residual stream。LayerNorm 会在每个 block 的线性子层入口重新标准化数值,但它没有抹掉残差状态本身的 group-level range mismatch。
这也是为什么只把 QKV、Softmax 或某几个 MatMul 改得更精细,无法恢复全图 W8A8。
图二:第一次爆炸发生在 block 2 的 MLP,而不是 attention
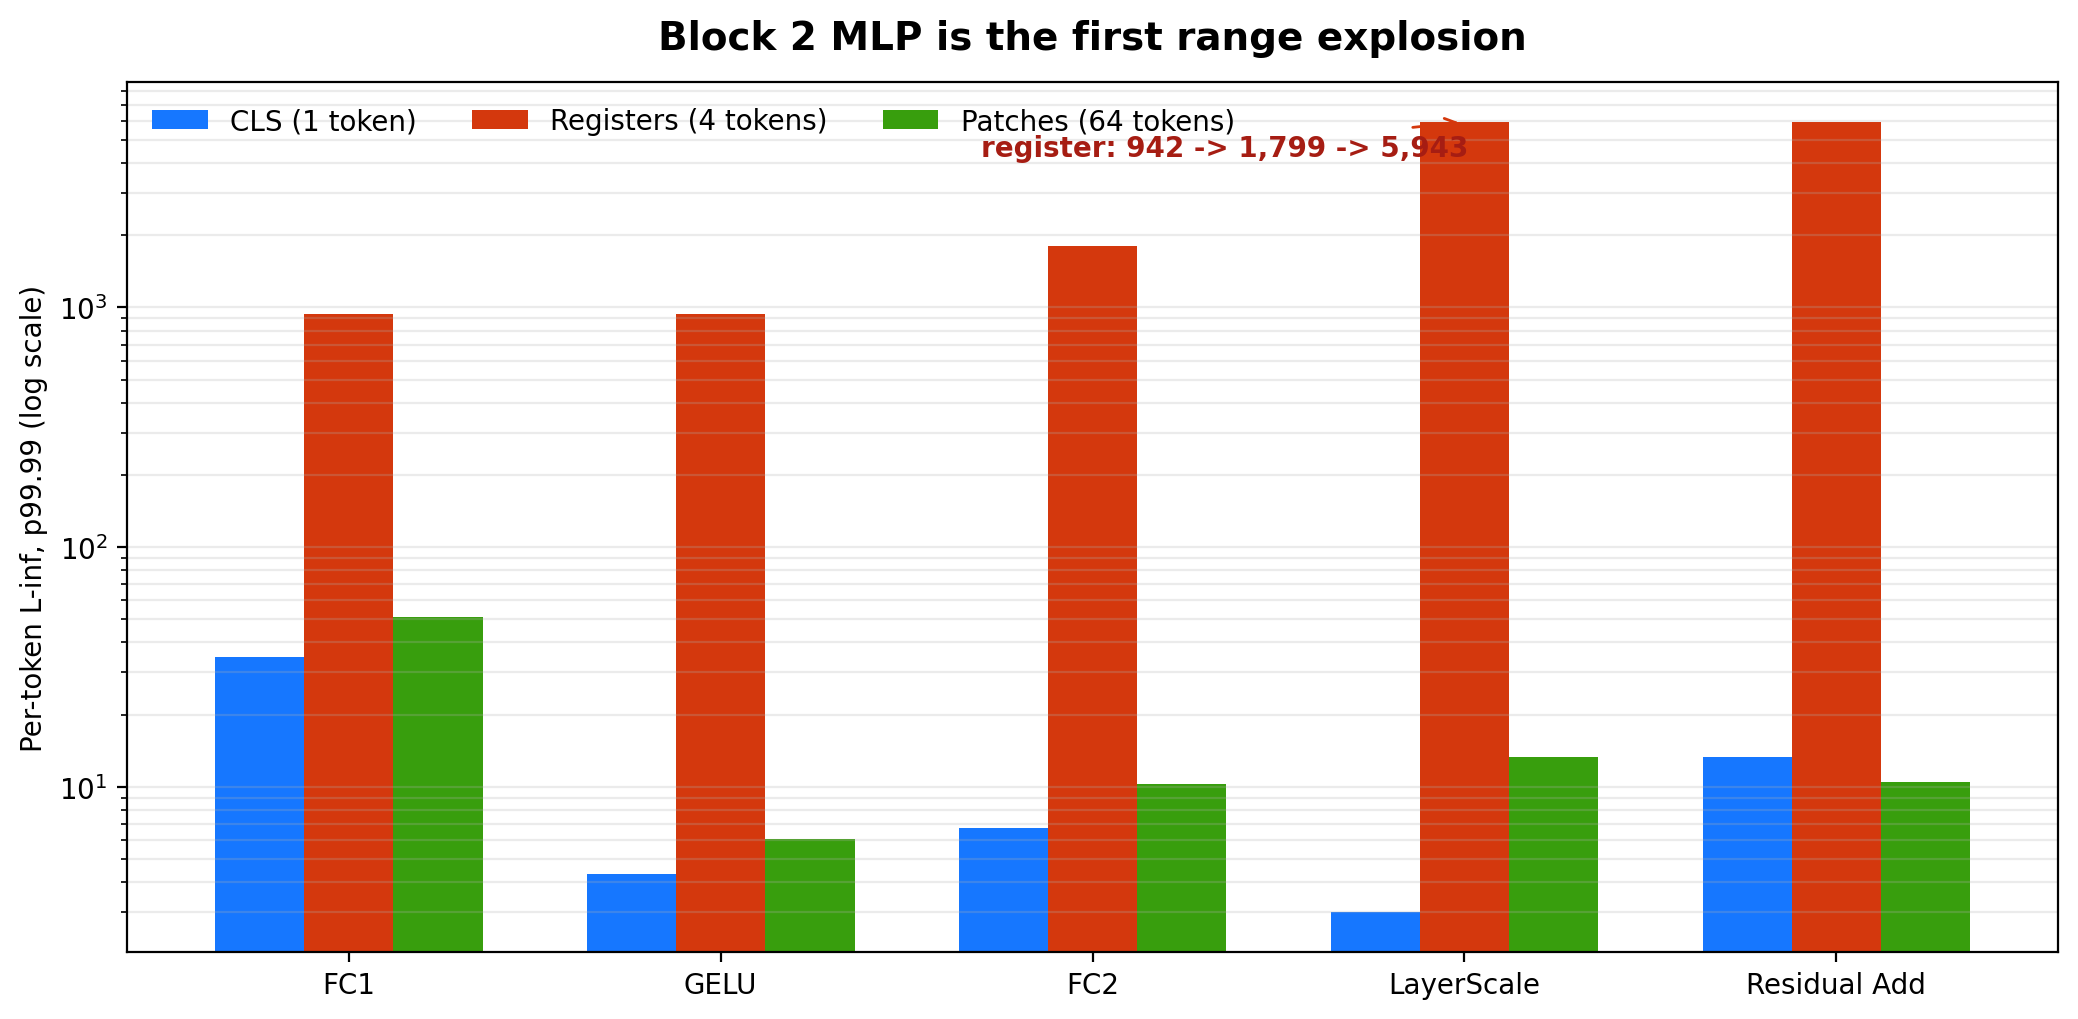
block 2 的 register token 沿 MLP 路径的数值是:
FC1:        942.3
GELU:       942.3
FC2:       1799.1
LayerScale: 5942.8
Residual Add: 5942.9
相同位置的 patch token 则是 GELU=6.04、FC2=10.26、LayerScale=13.30。在 LayerScale 输出处,register/patch 比约 447x;block 3 的 Add2 仍达到约 591x。
对于静态 per-tensor A8,所有 69 个 token 共享同一个 scale。校准到这个极端 register 后,patch 的峰值在 AIMET 的实际编码中只占约 0.37 个 quantization code。换句话说,patch 大量有意义的细节会落入相同的整数 bin。这不是少数 outlier 自身被近似的问题,而是它们使其余 64 个 patch 的分辨率消失。
LayerScale 到底做什么
LayerScale 最早由 CaiT 提出,用于让更深的 Image Transformer 更容易训练。每一个残差分支不是直接相加,而是先做逐通道缩放:
其中 是长度为 hidden dimension 的可学习向量,而不是每个 token 一个系数。它通常以很小的常数初始化,例如 DINO 系列实现中的 1e-5;这样训练刚开始时 residual update 很小,深层网络更稳定。训练完成后,gamma 会按通道学习到不同的大小和正负号。
这和 LayerNorm 不同:LayerNorm 对每个 token 的 channel 维度做标准化;LayerScale 不做标准化,也不会识别“哪个 token 是 outlier”。它只是把所有 token 在每一个 channel 上乘同一组 gamma。
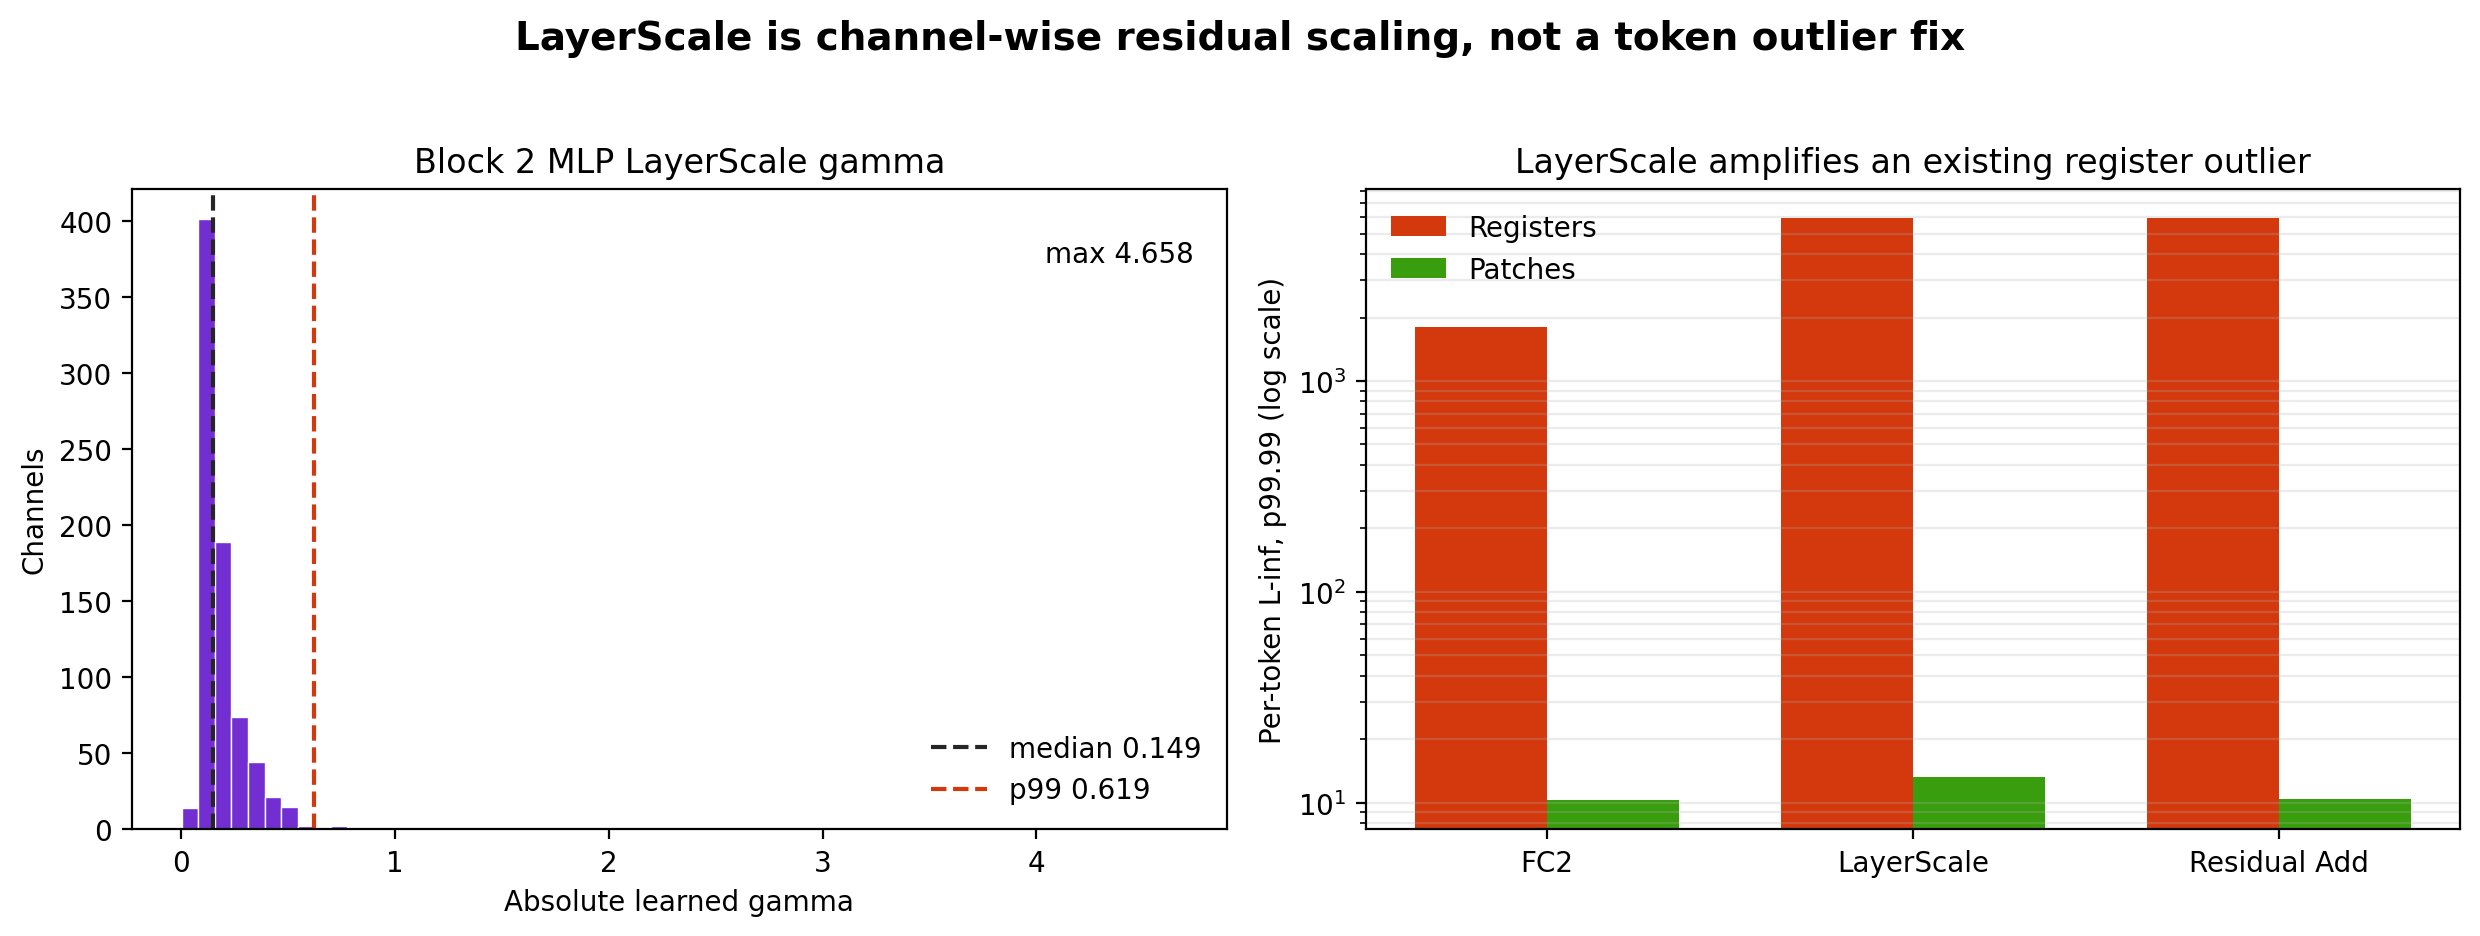
本模型 block 2 的 ls2.gamma 有 768 个元素,绝对值中位数是 0.149,p99 是 0.619,最大值为 4.658。这说明 LayerScale 在预训练之后不再是“微小常数”。它不是最初制造 register 异常的算子:FC1 的 register 已到 942.3;但 FC2 的异常值正好落到部分较大 gamma 对应的通道上时,LayerScale 会把它进一步推到 5942.8,再由 residual Add 保存下来。
所以正确表述是:LayerScale 是训练稳定化的逐通道残差门控;在这个具体 checkpoint 的 block 2,它放大了既有的 register outlier,因而成为 activation quantization 的关键边界,但不能靠“量化 LayerScale 更准”单独解决问题。
为什么常见 PTQ 技术没有直接解决
SmoothQuant、RepQ-ViT 一类方法主要在 LayerNorm 与线性层之间重分配 channel scale,能够改善 MatMul 输入/权重的局部不平衡。但这里的矛盾在 token 维:4 个 register 和 64 个 patch 共享同一 [1, 69, C] tensor 的 activation encoding,二者范围相差数百倍。
旋转保持范数,无法消除 register 的大能量;静态 clipping 会改写 FP 模型语义;仅对线性路径按 token 分组也不够,因为范围在 LayerScale + Add + LayerNorm 的基本算子上持续传播。FQ-ViT、TSPTQ-ViT 等工作使用多尺度 LayerNorm 或特殊整数非线性,本质上承认了“一个 tensor 需要多种数值尺度”,但它们依赖融合 kernel,并非普通 QNN 图中的单一 A8 tensor。
这对 V68 的含义
QNN V68 可以支持 A16 x W8 到 A16 MatMul,也支持 A16 Add;但标准 Concat 要求相同 dtype,运行时 MatMul activation 也不能用 token-axis 的 per-axis encoding。因此在不写自定义融合算子的前提下,严格的标准全图 W8A8 没有办法让 4 个 register 和普通 token 带着独立 scale 穿过 residual、LayerScale 和 LayerNorm。
当前最合理的工程路径是:register 持续使用 A16,普通 token 使用 A8,并在需要完整 token 序列的 attention 边界进行必要的转换。它依然要经过实际 context 生成和 HTP target 精度验证,不能把 AIMET 仿真结果直接当成端侧结论。
如果部署约束绝对要求全图 W8A8,则需求已经不是“换一种 observer”,而是 token-group 或 block-floating 数值格式,并且至少融合 grouped residual Add、LayerNorm、LayerScale,使 group encoding 能贯穿 MLP。这个方向仍是 PTQ,但属于 runtime/kernel 能力建设。
可复现性与下一步
本文三张图由 64 图 FP32 profile 和 ONNX 中 model.blocks.2.ls2.gamma 的参数自动生成。因此更新校准集或模型后,可以重新生成图,而不是手工改数字。
下一步会把 FP 分布与 A8 仿真的逐层误差并排,确定误差首次陡增的量化点;之后在真实 QNN V68 图上验证“register A16、其余 A8”的混合精度边界。本文直接支持的是“单一全图 A8 scale 会受 register outlier 限制”这一诊断,混合精度方案仍待端侧验证。
参考
- Going deeper with Image Transformers (CaiT):LayerScale 的原始论文。
- DINOv2 LayerScale 实现:逐通道
x * gamma,默认初始化1e-5。 - FQ-ViT:ViT 的 PTQ 与 LayerNorm/Softmax 特殊量化格式。